期末测试|消息队列100分试卷等你来挑战!

1、定义一个有状态的、通用的服务类:
public class StateServer {
    // 当前状态
    private ServerState serverState;
    // 启动
    public void start() {/*...*/}
    // 停止
    public void stop() {/*...*/}
    // 服务是否可用
    public boolean isAvailable() {/*...*/}
}

public enum ServerState {
  CREATED, // 刚刚创建,从未启动过;
  STARTING, // 正在启动中
  RUNNING, // 运行中
  STOPPING, // 停止中
  STOPPED,  // 已停止
  START_FAILED, // 启动失败
  STOP_FAILED // 停止失败
}
要求:
- 只有启动成功后才能正常提供服务,即 isAvailable() 返回 true。
- 这个类是一次性的,无论启动成功或者失败,只允许启动一次。
- 不允许定义其他变量记录任何状态。
要满足上述要求,实现 StateServer,至少需要下哪些状态:
A、RUNNING, STOPPED
B、CREATED, RUNNING, STOPPED
C、CREATED, STARTING, RUNNING, STOPPED
D、CREATED, STARTING, RUNNING, STOPPING, STOPPED
答案:B
题目解析
这个题要求我们使用最少的状态来实现一个一次性的有状态服务。我们来看看哪些状态是可以去掉的,剩下的就是必要的。首先,题目并没有要求做错误处理,所以用于记录错误的状态 START_FAILED 和 STOP_FAILED 是可以去掉的。然后我们看再来剩下的状态,它的状态转换图应该是什么样的:

通过这个图可以看出来,这里面只有当状态是 RUNNING 时,系统才能正常提供服务。停止的时候,无论停止成功或失败,会转换为 STOPPED,所以这个 STOPPING 也是可以省略的。那相应的,状态 STARTING 能不能省掉呢?虽然,STARTING 状态后续状态是有分支的,但其实也是可以省掉的,用 STOPPED 状态替换掉 STARTING 状态,并不影响类的业务逻辑,所以满足要求的最小状态图是这样的:
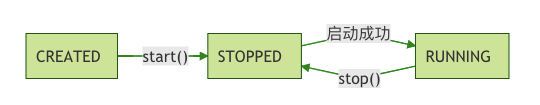
所以,这道题的正确答案是:B
2、一个存储集群,共有 7 个副本,集群采用一主多从的集群模式。当主副本失效的时候,可以保证在剩余存活的副本中,选出一个有最新数据的副本,作为主副本继续提供服务。要求:
- 写入成功的数据不允许丢失;
- 集群最多容忍 4 个副本故障,仍然可以提供服务。
客户端更新数据的时候,至少需要成功写入多少个副本才能返回“更新成功响应”?
A、2
B、3
C、4
D、不可能做得到
答案:D
题目解析
由于这个题中,要求最多可以容忍 4 个副本故障并且不能丢数据,那就必须保证每次更新数据,都更新到最少 5 个副本上,再返回响应。但是,当集群的故障副本数达到 4 个的时候,只剩 3 副本,达不到写入要求的最少 5 副本,这时候是无法提供数据更新服务的。这与题目的要求“4 个副本故障,仍然可以提供服务”是矛盾的,所以这道题的答案是 D,不可能做得到。
3、在分布式事务中,关于二阶段提交这个经典算法,以下哪个描述是正确的?
A、一个分布式事务中只能包含两个本地事务,超过两个本地事务需要用到三阶段提交或其他分布式事务算法。
B、在提交阶段,一旦某个本地事务提交失败,应该立即回滚整个分布式事务。
C、在提交阶段,如果没有宕机和网络传输信息丢失等硬件故障,提交肯定可以完成。
D、可以保证事务的隔离性。
答案:C
题目解析
选项 A,二阶段提交中的二阶段,并不是指两个本地事务,而是准备阶段和提交阶段这两个阶段。实际上,二阶段提交算法,在一个分布式事务中可以包含任意多个本地事务的。所以,选项 A 错误。
选项 B,在提交阶段,可能某些本地事务已经完成了提交,是没有办法回滚的。在提交阶段如果发生提交失败应该通过重试,完成分布式事务的提交。选项 B 错误。
选项 C,题交阶段,对于每个本地事务,只是修改本地事务的提交状态,不涉及变更业务数据,所以,排除网络传输信息丢失和宕机等硬件故障,提交肯定是可以成功的。选项 C 是正确的。
4、关于 RPC 框架中的“桩(Stub)”,以下哪个说法是正确的:
A、所有的桩都是 RPC 框架在运行时动态生成的。
B、桩和对应的服务实现类具有完全相同的方法签名。
C、桩运行在客户端。
D、桩运行在服务端。
答案:C
题目解析
在 RPC 框架中,桩是由 RPC 框架提供的一个服务端代理类的实例,它运行在客户端,选项 C 正确,D 错误。再来看选项 A,桩的确是由 RPC 框架生成的,但不是所有的 RPC 框架都会在运行时动态生成桩,有些 RPC 框架(比如 gRPC)是在编译 IDL 阶段生成的桩,所以选项 A 错误。
选项 B,桩和服务的实现类都实现了服务接口定义的所有方法,但不等于桩和对应的服务实现类具有完全相同的方法签名,服务实现类在实现服务接口定义的方法之外,还可以有其他业务方法,而桩是没有这些业务方法的,选项 B 也是错误的。
所以,这道题的正确答案是:C。
5、在 RocketMQ 的一个 Broker 上,使用一个消息序号消费某个队列的消息。其中,消息文件(commitlog)的数量是 m 个,所有消息文件中的消息条数是 k 条,目标队列对应的索引文件(consumerQueue)的数量是 n 个,队列中共有 j 条消息。查找消息的最快时间复杂度是:
A、O(1)
B、O(m) + O(n)
C、O(log m) + O(log n)
D、O(log k) + O(log j)
答案:A
题目解析
查找消息的时候,可以直接根据队列的消息序号,计算出索引的全局位置(索引序号 x 索引固定长度 20),然后直接读取这条索引,再根据索引中记录的消息的全局位置,找到消息。这里面比较耗时两个操作就是分别找到索引和消息所在文件,这两次查找是差不多的,都可以抽象成:
在一堆数字(文件名)中,找到一个比当前数字(索引或消息的全局位置)小且最接近当前数字的那个数字。
通常的做法是,把这些文件名组织成跳表、红黑树或者其他的树,这些数据结构最快查找时间都是 O(log n),所以,二次文件查找最快的时间复杂度是:O(log m) + O(log n)。RocketMQ 采用了一种更高效的方式组织文件:每个索引文件或者消息文件的长度的是固定的,对于每一组文件,都维护了一个由小到大有序的文件数组。查找文件的时候,直接通过计算即可获取文件在数组中的序号:
文件在数组中的序号 = (全局位置 – 第一个文件的文件名)/ 文件固定大小
在通过序号在数组中获取数据的时间复杂度是 O(1),二次查找文件的时间复杂度是:O(1) + O(1)= O(1),所以这道题的答案是 A。
6、假设一个 RocketMQ 集群部署在两个机房,每个机房都有一些 NameServer、Broker 和客户端节点,当两个机房间的链路中断时:
A、所有的 NameServer 都无法提供服务。
B、所有的 NameServer 都可以提供服务。
C、客户端只能在本机房的 NameServer 中找到本机房的 Broker。
D、客户端能在本机房的 NameServer 中找到所有的 Broker,但是部分 Broker 的数据已经过期。
答案:BC
题目解析
RocketMQ 集群中,NameServer 之间是不需要互相通信的,所以网络分区对 NameServer 本身的可用性是没有影响的,那选项 A 和 B 中,B 是正确的。如果 NameServer 检测到与 Broker 的连接中断了,NameServer 会认为这个 Broker 不再能提供服务。NameServer 会立即把这个 Broker 从路由信息中移除掉,避免客户端连接到一个不可用的 Broker 上去。
网络分区后,NameServer 收不到对端机房那些 Broker 的心跳,这时候,每个 NameServer 上都只有本机房的 Broker 信息,所以选项“C. 客户端只能在本机房的 NameServer 中找到本机房的 Broker”也是正确的,相应的,选项 D 就是错误的。
所以,这道题的答案是:BC。
7、以下是 Kafka 客户端源代码中 KafkaConsumer 类中的一段代码:
  private final AtomicLong currentThread = new AtomicLong(-1L);
  private final AtomicInteger refcount = new AtomicInteger(0);
  private void acquire() {
      long threadId = Thread.currentThread().getId();
      if (threadId != currentThread.get() && !currentThread.compareAndSet(-1L, threadId))
          throw new Exception("...");
      refcount.incrementAndGet();
  }
  private void release() {
      if (refcount.decrementAndGet() == 0)
          currentThread.set(-1L);
  }


  void foo() {
    acquire()
    try {
      // 更新数据
    } finally {
      release();
    }
  }
关于 foo() 方法,以下哪些说法是正确的:
A、并发调用会导致数据错误
B、并发调用不会导致数据错误
C、只能单线程调用
D、可以并发调用提升性能
答案:BC
题目解析
这里面的的 acquire() 和 release(),其实是一种并发检测防呆机制,作用是,当检测到并发调用的时候抛出异常。所以,本质上,foo() 方法还是只能单线程访问,但有了这种检测机制,就可以保证,当有一个线程在更新数据的时候,其他线程的调用都会抛出异常。
Kafka“主动检测不支持的情况并抛出异常,避免系统产生不可预期的行为”这种模式,对于增强系统的健壮性是一种非常有效的做法。
所以,这道题的答案是:BC。
8、ZooKeeper 是一个分布式一致性的存储系统,如果不考虑性能差异,以下这些场景,哪些场景下可以用 MySQL 替代 ZooKeeper?
A、作为分布式锁保护共享资源
B、保存元数据
C、选举
D、监控集群节点存活状态
答案:ABC
题目解析
这个题考察的其实是对 ZooKeeper 的理解,你需要知道这 4 个场景都是如何用 ZooKeeper 来实现的,然后就很容易分析出答案了。
选项 A,利用 ZooKeeper 来实现分布式锁,实际上利用的是 ZooKeeper 操作的原子性,那 MySQL 同样可以利用数据库事务保证执行 SQL 的原子性,所以选项 A 是正确的。
选项 B,保存元数据需要一个一致性的存储系统,这一点 ZooKeeper 和 MySQL 都可以保证数据一致性,所以选项 B 也是正确的。
选项 C,虽然 ZooKeeper 本身的选举机制很复杂,但使用 ZooKeeper 进行选举就比较简单了,各业务节点在 ZooKeeper 中抢占创建同一个 ZNode,ZooKeeper 可以保证至多只有一个节点创建成功,这个节点就是选举出来的主节点。这个选举方法实际上也是利用了 ZooKeeper 操作的原子性,同样 MySQL 也可以替代。所以选项 C 也是正确的。
选项 D,监控节点存活状态,利用的是 ZooKeeper 的临时节点加上 watch 机制这两个特性,这两个特性都是 MySQL 不具备的,所以选项 D 是不正确的。
所以,这道题的答案是:ABC。
9、在设计一个使用 MQTT 协议通信的海量 IoT 集群时,需要重点考虑哪些问题?
A、海量连接数
B、海量 MQTT Topic 数量
C、网络连接频繁中断的问题
D、如何解决服务端向 IoT 设备下发指令的问题
答案:AB
题目解析
这个题考察的是对 MQTT 协议的理解以及 IoT 场景的特性。由于 MQTT 协议采用的是长连接,海量的 IoT 设备必然带来海量的连接数,另外,每个 IoT 设备都会建立一个专属的 MQTT Topic,所以海量的 IoT 设备也会导致海量的 Topic 数量,所以选项 A、B 都是需要考虑的问题。
选项 C、D,这两个问题都是在 MQTT 协议内就已经解决的问题,所以并不需要我们在设计的时候过多的关注。
所以,这道题的答案是:AB。
10、以下哪些场景采用了存储计算分离的设计思想:
A、标准的微服务集群
B、Kafka 集群
C、Hadoop 集群
D、Pulsar 集群
答案:ACD
题目解析
存储计算分离的设计思想,就是将系统的存储职责和计算职责分离开,存储节点只负责数据存储,而计算节点只负责计算,也就是执行业务逻辑。这 4 个选项中,ACD 这三个选项采用的都是这个设计思想。
所以,这道题的答案是:ACD。