aj137ya

技术栈测试
1、学Java看的哪个资料:
培训机构的课程
- 重载,重写,泛型懂吗?
学过 - Java集合这块学过了吗?
学过,大部分忘了 - HashMap源码,JVM,JUC是否看过:
HashMap看过,忘了
2、数据结构与算法看的哪个资料:
学校教材
- 链表,栈,队列,二叉树能自己手写吗:
突击几天可以 - AVL树,红黑树,线段树学过吗:
- 冒泡,快速,归并排序能手写吗:
冒泡可以,其它的忘了 - 递归,二分,贪心,回溯,动规,枚举这几种算法学过哪几种:
动规枚举不会,其它简单的可以 - LeetCode 大概刷了多少题:
73题
3、框架与中间件
- servlet,cookie,session学过吗:
学过忘了 - SSM学过了吗:
学过忘了 - redis 学过吗:
学过忘了 - SpringBoot项目做过几个:
三四个吧
4、MySQL看的哪些资料:
- sql 熟练吗:
一般 - 索引底层原理懂吗:
5、计算机基础
- 计算机网络看什么资料:
学校教程,基本忘了 - 操作系统看什么资料:
学校教程,基本忘了 - 计算机组成原来看的什么资料:
学校教程,基本忘了
学习规划(2024.1.6)
一些链接入口
课程大纲: 所有课程大纲入口 ,PS:你要的东西,课程大纲基本都会有哈,需要学啥记得来课程大纲看看。
你的大致情况分析与规划
你的基础这块,还是比较差的,不过也正常,薪资低一些,不过你那边可能非一线城市,不过我觉得你好好把技术学一下,应该还是有挺大的提升空间的,接下来我们就做三个事:
1、你看看你能不能再回顾梳理下你做过的内容,然后进行一些包装
2、再做一个项目,目的是为了包装进去
3、学习核心八股文
目标:年后三月份找工作
具体学习计划安排
1、梳理你自己的项目,感觉这个需要靠你,你看看能不能编一些redis,mysql优化啥的进去,或者等你做完项目我们再来商量怎么加也行。
2、再做一个项目,就做这个论坛项目吧,到时候可以进行包装:SpringBoot+MQ+ES项目,然后等你做完,再考虑要不要做微服务的项目。
时间:7天。
3、八股文:这块内容比较多,我们先学习核心的:JVM+mysql,系统过一下,其他直接基于我总结的高频题学习就行,等你学了后还有时间,有些再去相对系统学吧,具体如下:
(1)、Java进阶=》JVM入门:Java需要继续补充下,学习 Java进阶,根据目录说的学,如果掌握了就跳过,主要看我划出来的那些。之后看 图解JVM学习指南 就行
(2)、mysql:mysql 你看 MySQL原理剖析课程说明,重点看下我标🌟的就行
时间:20天
4、复习:八股文学了就忘了,所以这里都有各种强化复习的。
第一轮复习(必须完成):刷高频题,按照 八股文高频题库(必看) 进行第一轮复习,核心学的差不多,就准备去投递简历了。
第二轮复习(非必需):之后按 面试突击专题学习指南(必看) 进行第二轮复习,这个时候你已经能够应付挺多八股文了,但是八股文学无止境,之后学完有时间再回归系统学习,我会给你推荐对应的书籍和专栏。
PS:由于社招对计算机网络,操作系统这些要求不高,所以你只需要掌握高频题里,我说的那些文章的题就行
时间:30天,之后就全力进入面试,在面试成长了。
学习顺序
可以 2 + 3 同时学习,1 的话,等学的差不多,要写简历了,咱们再来商量。
就行先安排这么多,然后记得来每周打卡学习进度哈,也可以星球每天打卡哦,我会看的,比如像他们这样:0. 每周打卡做的比较好的成员示例,你也可以每天打卡或者星球打卡吧,我会看的
有什么问题记得随时私聊帅地
学习打卡
第一周
周天 2024/1/7
- 类变量与类方法详解
- 小结:静态方法,只能访问静态的成员,非静态的方法,可以访问静态成员和非静态成员(必须遵守访问权限)
- main 方法
- 执行main方法传入参数的两种方式:1.命令行执行时传入 2.DIEA设置传入
第二周
周二 2024/1/9
一. 代码块
- static代码块也叫静态代码块,作用就是对类进行初始化,而且它随着类的加载而执行,并且只会执行一次。如果是普通代码块,每创建一个对象,就执行。
- 类什么时候被加载【重要】
①创建对象实例时(new)
②创健子类对象实例,父类也会被加载;先加载父类再加载子类
③使用类的静态成员时(静态属性,静态方法) - 普通的代码块,在创建对象实例时,会被隐式的调用。被创建一次,就会调用一次,如果只是使用类的静态成员时,普通代码块并不会执行。可以理解为构造器被调用时普通代码块才会执行。
- 创建一个对象时,在一个类中调用顺序是:(重点,难点)
①调用静态代码块和静态属性初始化(注意:静态代码块和静态属性初始化调用的优先级一样,如果有多个静态代码块和多个静态变量初始化,则按他们定义的顺序调用)
②调用普通代码块和普通属性的初始化(注意:普通代码块和普通属性初始化调用的优先级一样,如果有多个普通代码块和多个普通属性初始化,则按定义顺序调用)
③调用构造方法。 - 构造方法(构造器)的最前面其实隐含了super()和调用普通代码块。静态相关的代码块、属性初始化在类加载时就执行完毕,因此是优先于构造器和普通代码块执行的。
二. 单例设计模式
- 什么是设计模式
设计模式是在大量的实践中总结和理论化之后优选的代码结构、编程风格,以及解决问题的思考方式。 - 什么是单例模式
所谓类的单例设计模式,就是采取一定的方法保证在整个的软件系统中,对某个类只能存在一个对象实例,并且该类只提供一个取得其对象实例的方法。 - 单例模式有两种方式:
1) 饿汉式
//1.构造器私有化=》防止直接new
//2.类的内部创建对象
//3.向外暴露一个静态的公共方法。getInstance()
cLass GirlFriend {
  private String name;
  //为了能够在静态方法中,返回gf对象,需要将其修饰为static
  //通常是重量级的对象,饿汉式可能造成创建了对象,但是沒有使用
  private static GirlFriend gf = new GirlFriend("小红红");
  private GirlFriend(String name){
    this.name = name;
  }
  public static GirlFriend getInstance(){
    return gf;
  }
}
2) 懒汉式
//希望在程序运行过程中,只能创建一个Cat对象
//使用单例模式
class Cat {
  private String name;
  private static Cat cat
  //步骤
  //1.仍然构造器私有化
  //2.定义一个static静态属性对象
  //3.提供一个public的static方法,可以返回一个Cat对象
  //4.懒汉式,只有当用户使用getInstance时,才返回cat对象,后面再次调用时,会返回上次创建的cat对象从而保证了单例
  private Cat(String name){
    this.name = name;
  }
  public static Cat getInstance(){
    if(cat == null){//如果还沒有创建cat对象
      cat = new Cat("小可爱");
    }
  }
  return cat;
}
- 饿汉式VS懒汉式
- 二者最主要的区别在于创建对象的时机不同:饿汉式是在类加载就创建了对象实例,而懒汉式是在使用时才创建。
- 饿汉式不存在线程安全问题,懒汉式存在线程安全问题。(后面学习线程后,会完善)
- 饿汉式存在浪费资源的可能。因为如果程序员一个对象实例都没有使用,那么饿汉式创建的对象就浪费了,懒汉式是使用时才创建,就不存在这个问题。
- 在我们javaSE标准类中,java.lang.Runtime就是经典的单例模式。
public class Runtime {
      private static Runtime currentRuntime new Runtime();
      public static Runtime getRuntime(){
        return currentRuntime;
      }
      private Runtime() {}
}
三. final 关键字
- final中文意思:最后的,最终的
final可以修饰类、属性、方法和局部变量 -
在某些情况下,程序员可能有以下需求,就会使用到final:
1.当不希望类被继承时,可以用final修饰
2.当不希望父类的某个方法被子类覆盖/重写(override)时,可以用final关键字修饰
3.当不希望类的的某个属性的值被修改,可以用final修饰
4.当不希望某个局部变量被修改,可以使用final修饰 -
final使用注意事项和细节讨论
1.final修饰的属性又叫常量,一般命名时使用大写
2.fial修饰的属性在定义时,必须赋初值,并且以后不能再修改,赋值可以在如下位置之一【选择一个位置赋初值即可】:
①定义时:如public final double TAX RATE=0.08;
②在构造器中
③在代码块中 -
如果final修饰的属性是静态的,则初始化的位置只能是
1.定义时
2.在静态代码块中 -
final类不能继承,但是可以实例化对象。
-
如果类不是final类,但是含有final方法,则该方法虽然不能重写,但是可以被继承。
-
一般来说,如果一个类已经是final类了,就没有必要再将方法修饰成final方法。
-
final不能修饰构造方法(即构造器)
-
final和static往往搭配使用,效率更高,不会导致类加载,底层编译器做了优化处理。
-
包装类(Integer,Double,Float,Boolean等都是final),String也是final类。
周三 2024/1/10
一. 抽象类
- 当父类的某些方法,需要声明,但是又不确定如何实现时,可以将其声明为抽象方法,那么这个类就是抽象类
- 抽象类的介绍
1)用abstract关键字来修饰一个类时,这个类就叫抽象类访问修饰符 abstract 类名{ }
2)用abstract关键字来修饰一个方法时,这个方法就是抽象方法访问修饰符 abstract 返回类型 方法名(参数列表);//没有方法体
3)抽象类的价值更多作用是在于设计,是设计者设计好后,让子类继承并实现抽象类
4)抽象类,是考官比较爱问的知识点,在框架和设计模式使用较多 - 抽象类使用的注意事项和细节讨论
- 抽象类不能被实例化
- 抽象类不一定要包含abstract方法。也就是说,抽象类可以没有abstract方法,但可以有实现的方法
- 一旦类包含了abstract方法,则这个类必须声明为abstract
- abstract只能修饰类和方法,不能修饰属性和其它的
- 抽象类可以有任意成员【抽象类本质还是类】,比如:非抽象方法、构造器、静态属性等等
- 抽象方法不能有主体
- 如果一个类继承了抽象类,则它必须实现抽象类的所有抽象方法,除非它自己也声明为abstract类
- 抽象方法不能使用private、final和static来修饰,因为这些关键字都是和重写相违背的
二. 接口
- 在Jdk7.0前接口里的所有方法都没有方法体,即都是抽象方法
- Jdk8.0后接口可以有静态方法,默认方法,也就是说接口中可以有方法的具体实现
- 接口不能被实例化
- 接口中所有的方法是public方法,接口中抽象方法,可以不用abstract修饰
- 一个普通类实现接口就必须将该接口的所有方法都实现
- 抽象类实现接口,可以不用实现接口的方法
- 一个类同时可以实现多个接口
- 接口中的属性,只能是fina的,而且是public static final修饰符。比如:inta=1;实际上是public static final int a=1;(必须初始化)
- 接口中属性的访问形式:接口名.属性名
- 一个接口不能继承其它的类,但是可以继承多个别的接口
interface A extends B,C{} - 接口的修饰符只能是public和默认,这点和类的修饰符是一样的
-
实现接口Vs继承类
- 接口和继承解决的问题不同
继承的价值主要在于:解决代码的复用性和可维护性。
接口的价值主要在于:设计,设计好各种规范(方法),让其它类去实现这些方法。即更加的灵活. - 接口比继承更加灵活
接口比继承更加灵活,继承是满足is-a的关系,而接口只需满足like-a的关系 - 接口在一定程度上实现代码解耦[即:接口规范性+动态绑定]
- 接口和继承解决的问题不同
- 接口的多态特性
- 多态参数
- 多态数组
- 接口存在多态传递现象
周四 2024/1/11
一. 内部类
- 基本介绍
一个类的内部又完整的嵌套了另一个类结构。被嵌套的类称为内部类(inner class),嵌套其他类的类称为外部类(outer class)。是我们类的第五大成员【思考:类的五大成员是哪些?[属性、方法、构造器、代码块、内部类]】,内部类最大的特点就是可以直接访问私有属性,并且可以体现类与类之间的包含关系,注意:内部类是学习的难点,同时也是重点,后面看底层源码时,有大量的内部类。
//基本语法
class Outer{//外部类
    class Inner{
      /内部类
      class Other{/外部其他类
    }
}
- 内部类的分类
定义在外部类局部位置上(比如方法内)
1)局部内部类(有类名)
2)匿名内部类(没有类名,重点!!!)定义在外部类的成员位置上:
1)成员内部类(没用static修饰)
2)静态内部类(使用static修饰) - 局部内部类的使用
说明:局部内部类是定义在外部类的局部位置,比如方法中,并且有类名。- 可以直接访问外部类的所有成员,包含私有的
- 不能添加访问修饰符,因为它的地位就是一个局部变量。局部变量是不能使用修饰符的。但是可以使用final修饰,因为局部变量也可以使用final
- 作用域:仅仅在定义它的方法或代码块中。
- 局部内部类–访问–>外部类的成员[访问方式:直接访问]
- 外部类–访问–>局部内部类的成员
访问方式:创建对象,再访问(注意:必须在作用域内)
记住:
(1)局部内部类定义在方法中/代码块
(2)作用域在方法体或者代码块中
(3)本质仍然是一个类- 外部其他类不能访问—>局部内部类(因为局部内部类地位是一个局部变量)
- 如果外部类和局部内部类的成员重名时,默认遵循就近原则,如果想访问外部类的成员,则可以使用(外部类名.ths.成员)去访问【演示】
System.out.printIn("外部类的n2=”+外部类名.this.n2);
- 匿名内部类的使用(重要!!!!!!!)
(1)本质是类
(2)内部类
(3)该类没有名字
(4)同时还是一个对象说明:匿名内部类是定义在外部类的局部位置,比如方法中,并且没有类名
- 匿名内部类的基本语法
new 类或接口(参数列表){类体}
- 匿名内部类的基本语法
- 匿名内部类的使用
- 匿名内部类的语法比较奇特,请大家注意,因为匿名内部类既是一个类的定义同时它本身也是一个对象,因此从语法上看,它既有定义类的特征,也有建对象的征,对前面代码分析可以看出这个特点,因此可以调用匿名内部类方法。
- 可以直接访问外部类的所有成员,包含私有的
- 不能添加访问修饰符,因为它的地位就是一个局部变量
- 作用域:仅仅在定义它的方法或代码块中
- 匿名内部类–访问–>外部类成员[访问方式:直接访问]
- 外部其他类–不能访问–>匿名内部类(因为匿名内部类地位是一个局部变量)
- 如果外部类和匿名内部类的成员重名时,匿名内部类访问的话,默认遵循就近原则如果想访问外部类的成员,则可以使用(外部类名.this.成员)去访问
周五 2024/1/12
一. 内部类
- 成员内部类的使用
说明:成员内部类是定义在外部类的成员位置,并且没有static修饰。
- 可以直接访问外部类的所有成员,包含私有的
- 可以添加任意问修饰符(public、protected、默认、private),因为它的地位就是一个成员。
- 作用域和外部类的其他成员一样,为整个类体,在外部类的成员方法中创建成员内部类对象,再调用方法
- 成员内部类–访问–>外部类(比如:属性)[访问方式:直接访问]
- 外部类–访问—>内部类
访问方式:创建对象,再访问 - 外部其他类–访问–>成员内部类
- 静态内部类的使用
说明:静态内部类是定义在外部类的成员位置,并且有static修饰
- 可以直接访问外部类的所有静态成员,包含私有的,但不能直接访问非静态成员
- 可以添加任意访问修饰符(public、protected、默认、private),因为它的地位就是一个成员。
- 作用域:同其他的成员,为整个类体
- 静态内部类–访问—>外部类(比如:静态属性)[访问方式:直接访问所有静
态成员] - 外部类–访问—>静态内部类访问方式:创建对象,再访问
- 外部其他类–访问–一>静态内部类
- 如果外部类和静态内部类的成员重名时,静态内部类访问的时,默认遵循就近原则,如果想访问外部类的成员,则可以使用(外部类名,成员)去访问
第三周
周一 2024/1/15
11.异常
- 异常的概念
- 基本概念
Java语言中,将程序执行中发生的不正常情况称为“异常”。(开发过程中的语法错误和逻辑错误不是异常) - 执行过程中所发生的异常事件可分为两大类
- Error(错误:Java虚拟机无法解决的严重问题。如:JVM系统内部错误、资源耗尽等严重情况。比如:StackOverflowError[栈溢出]和OOM(out of memory),Error是严重错误,程序会崩溃。
- Exception:其它因编程错误或偶然的外在因素导致的一般性问题,可以使用针对性的代码进行处理。例如空指针访问,试图读取不存在的文件,网络连接中断等等,Exception分为两大类:运行时异常[程序运行时发生的异常]和编译时异常[编译时,编译器检查出的异常]
- 基本概念
- 异常体系图(!!!)

- 异常体系图的小结
- 异常分为两大类,运行时异常和编译时异常
- 运行时异常,编译器不要求强制处置的异常。一般是指编程时的逻辑错误,是程序员应该避免其出现的异常。java.lang.RuntimeException类及它的子类都是运行时异常
- 对于运行时异常,可以不作处理,因为这类异常很普遍,若全处理可能会对程序的可读性和运行效率产生影响
- 编译时异常,是编译器要求必须处置的异常。
- 常见的异常
常见的运行时异常包括- NullPointerException空指针异常
- ArithmeticException数学运算异常
- ArrayIndexOutOfBoundsException数组下标越界异常
- ClassCastException类型转换异常
- NumberFormatException数字格式不正确异常[]
- 异常处理概念
异常处理就是当异常发生时,对异常处理的方式。 - 异常处理分类
- try-catch-finally
程序员在代码中捕获发生的异常,自行处理 - Java提供try和catch块来处理异常。try块用于包含可能出错的代码。catch:块用于处理try块中发生的异常。可以根据需要在程序中有多个的try…catch块。
- 基本语法
try{
//可疑代码
//将异常生成对应的异常对象,传递给catch:块
}catch(异常){
//对异常的处理
}
- try-catch方式处理异常-注意事项
- 如果异常发生了,则异常发生后面的代码不会执行,直接进入到catch块
- 如果异常没有发生,则顺序执行try的代码块,不会进入到catch.
- 如果希望不管是否发生异常,都执行某段代码(比如关闭连接,释放资源等)则使用如下代码-finally{}
try{ //可疑代码 }catch(异常){ // }finally{ //释放资源等 - 可以有多个catch语句,捕获不同的异常(进行不同的业务处理),要求父类异常在后,子类异常在前,比如(Exception在后,NullPointerException在前,如果发生异常,只会匹配一个catch
try{ }catch(NullPointerExcetpion e){ }catch(Exception e){ }finally{ } - 可以进行tr个finally配合使用,这种用法相当于没有捕获异常,因此程序会直接崩掉。
try{
}finally{
}
- throws
将发生的异常抛出,交给调用者(方法)来处理,最顶级的处理者就是JVM - 如果一个方法(中的语句执行时)可能生成某种异常,但是并不能确定如何处理这种异常,则此方法应显示地声明抛出异常,表明该方法将不对这些异常进行处理,而由该方法的调用者负责处理。
2.在方法声明中用throws语句可以声明抛出异常的列表,throws后面的异常类型可以是方法中产生的异常类型,也可以是它的父类。
- 注意事项和使用细节
- 对于编译异常,程序中必须处理,比如try-catch或者throws
- 对于运行时异常,程序中如果没有处理,默认就是throws的方式处理
- 子类重写父类的方法时,对抛出异常的规定:子类重写的方法,所抛出的异常类型要么和父类抛出的异常一致,要么为父类抛出的异常的类型的子类型
- 在throws过程中,如果有方法try-catch,就相当于处理异常,就可以不必throws
- try-catch-finally
- 自定义异常
当程序中出现了某些”错误”,但该错误信息并没有在Throwable子类中描述处理,这个时候可以自己设计异常类,用于描述该错误信息。 - throw和throws的对比
意义 位置 后面跟的东西 throws 异常处理的一种方式 方法声明处 异常类型 throw 手动生成异常对象的关键字 方法体中 异常对象
15.包装类
- 包装类和基本数据的转换
- jdk5前的手动装箱和拆箱方式,装箱:基本类型->包装类型,反之,拆箱
- jdk5以后(含jdk5)的自动装箱和拆箱方式
- 自动装箱底层调用的是valueOf方法,比如Integer..valueof()
public class WrapperVSString {
  public static void main(String[] args) {
    //包装类(Integer)->String
    Integer i = 100;//自动装箱
    韩顺平循序渐进学Java 零基础第536页//方式 1
    String str1 = i + "";
    //方式 2
    String str2 = i.toString();
    //方式 3
    String str3 = String.valueOf(i);
    //String -> 包装类(Integer)
    String str4 = "12345";
    Integer i2 = Integer.parseInt(str4);//使用到自动装箱
    Integer i3 = new Integer(str4);//构造器
    System.out.println("ok~~");
  }
}
周二 2024/1/16
16.String类
- String类的理解和创建对象
- String对象用于保存字符串,也就是一组字符序列
- 字符串常量对象是用双引号括起的字符序列。例如:”你好”、”12.97”、”boy”等
- 字符串的字符使用Unicode字符编码,一个字符(不区分字母还是汉字)占两个字节。
- String类较常用构造器(其它看手册):
String s1 = new String(); String s2 = new String(String original); String s3 = new String(char[] a); String s4 = new String(char[] a,int startlndex,int count); String s5 = new String(byte[] b); - String类实现了接口Serializable【String可以串行化:可以在网络传输】
String类实现了接口Comparable【String对象可以比较大小】 - String是final类,不能被其他的类继承
- String有属性private final char value[]用于存放字符串内容
- 一定要注意:valve是一个final类型,不可以修改:即valve不能指向新的地址,但是单个字符内容是可以变化
- 创建String对象的两种方式
- 方式一:直接赋值
String s = "hspedu"; - 方式二:调用构造器
String s = new String("hspedu");
- 方式一:直接赋值
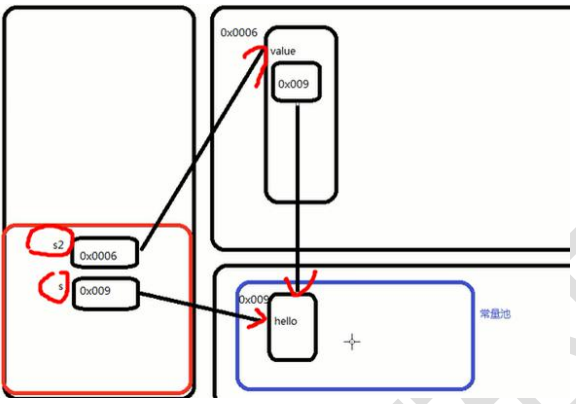
- 两种创建String对象的区别
方式一:直接赋值String s = "hsp";
方式二:调用构造器String s2 = new String("hsp");- 方式一:先从常量池查看是否有”hsp”数据空间,如果有,直接指向;如果没有则重新创建,然后指向。s最终指向的是常量池的空间地址
- 方式二:先在堆中创建空间,里面维护了value属性,指向常量池的hsp空间,如果常量池没有”hsp”,重新创建,如果有,直接通过value:指向。最终指向的是堆中的空间地址。
- 画出两种方式的内存分布图
第四周
周二 2024/1/23
17. StringBuffer 与 StringBuilder
- StringBuffer基本介绍
- java.lang.StringBuffer代表可变的字符序列,可以对字符串内容进行增删。
- 很多方法与String相同,但String Buffer:是可变长度的。
- StringBuffer是一个容器。
- String VS String Buffer
- String保存的是字符串常量,里面的值不能更改,每次String类的更新实际上就是更改地址,效率较低
//private final char value[]; - String Buffer保存的是字符串变量,里面的值可以更改,每次StringBufferl的更新实际上可以更新内容,不用每次更新地址,效率较高
//char[] value;//这个放在堆
- String保存的是字符串常量,里面的值不能更改,每次String类的更新实际上就是更改地址,效率较低
- StringBuilder基本介绍
- 一个可变的字符序列。此类提供一个与StringBuffer兼容的API,但不保证同步(StringBuilder不是线程安全的)。该类被设计用作StringBuffer的一个简易替换,用在字符串缓冲区被单个线程使用的时候。如果可能,建议优先采用该类,因为在大多数实现中,它比StringBuffer要快。
- 在StringBuilder上的主要操作是append和insert方法,可重载这些方法,以接受任意类型的数据。
- String、StringBuffer和StringBuilder的比较
- StringBuilder和StringBuffer非常似,均代表可变的字符序列,而且方法也一样
- String:不可变字符序列,效率低,但是复用率高。
- StringBuffer:可变字符序列、效率较高(增删)、线程安全
- StringBuilder:可变字符序列、效率最高、线程不安全
- String使用注意说明:
string s="a";//创建了一个字符串
s+="b";//实际上原来的"a"字符串对象已经丢弃了,现在又产生了一个字符串s+"b”(也就是"b")。如果多次执行这些改变串内容的操作,会导致大量副本字符串对象存留在内存中,降低效率。如果这样的操作放到循环中,会极大影响程序的性能=>结论:如果我们对String做大量修改,不要使用String
- String、String Buffer和String Builder的选择使用的原则,结论:
- 如果字符串存在大量的修改操作,一般使用StringBuffer或String Builder
- 如果字符串存在大量的修改操作,并在单线程的情况,使用StringBuilder
- 如果字符串存在大量的修改操作,并在多线程的情况,使用StringBuffer
- 如果我们字符串很少修改,被多个对象引用,使用String,比如配置信息等
- StringBuilder的方法使用和StringBuffer一样,不再说.
21. List | ArrayList | Vector
- List接口基本介绍
List接口是Collection接口的子接List,java- Lst集合类中元素有序(即添加顺序和取出顺序一致)、且可重复。
- List集合中的每个元素都有其对应的顺序索引,即支持索引。
- Lst容器中的元素都对应一个整数型的序号记载其在容器中的位置,可以根据序号存取容器中的元素。
周三 2024/1/24
- List的三种遍历方式[ArrayList,LinkedList,Vector]
//1.方式一:使用iterator
lterator iter = col.iterator();
while(iter.hasNext()){
    Object o = iter.next();
}
//2.方式二:使用增强for
for(Object o:col){
}
//3.方式三:使用普通for
for(int i=0;i<list.size();i++){
    Object object = list.get(i);
    System.out.println(object);
}
- ArrayList 底层结构和源码分析
- ArrayList 的注意事项
- permits all elements,including null,ArrayList可以加入null,并且多个
- ArrayList是由数组来实现数据存储的
- ArrayList基本等同于Vector,除了ArrayList是线程不安全(执行效率高)看源码.在多线程情况下,不建议使用ArrayList
- ArrayList 的底层操作机制源码分析(重点,难点.)
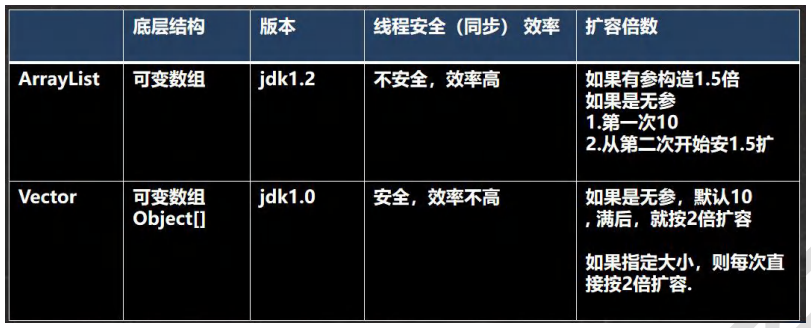
- ArrayList中维护了一个Object类型的数组elementData.
transient Object[] elementData;//transient表示瞬间,短暂的,表示该属性不会被序列号 - 当创建ArrayList对象时,如果使用的是无参构造器,则初始elementData容量为0,第1次添加,则扩容elementData为10,如需要再次扩容,则扩容elementData为1.5倍。
- 如果使用的是指定大小的构造器,则初始elementData容量为指定大小,如果需要扩容,则直接扩容elementData为1.5倍。
- ArrayList中维护了一个Object类型的数组elementData.
- ArrayList 的注意事项
- Vector 底层结构和源码剖析
- Vector 的基本介绍
- Vector类的定义说明
public class Vector extends AbstractList implements List,RandomAccess,Cloneable,Serializable - Vector底层也是一个对象数组,
protected Object[]elementData; - Vector是线程同步的,即线程安全,Vector类的操作方法带有synchronized
public synchronized E get(int index){ if (index > elementCount) throw new ArrayIndexOutOfBoundsException(index); return elementData(index); } - 在开发中,需要线程同步安全时,考虑使用Vector
- Vector类的定义说明
- Vector 和 ArrayList 的比较
- LinkedList 底层结构
- LinkedList 的全面说明
- LinkedList底层实现了双向链表和双端队列特点
- 可以添加任意元素(元素可以重复),包括null
- 线程不安全,没有实现同步
- LinkedList 的底层操作机制
- LinkedList底层维护了一个双向链表
- LinkedList中维护了两个属性first和last分别指向首节点和尾节点
- 每个节点(Node对象),里面又维护了prev、next、item三个属性,其中通过prev指向前一个,通过next指向后一个节点。最终实现双向链表。
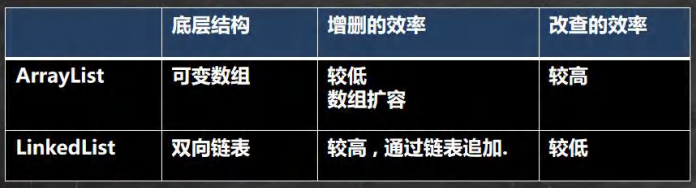
- 所以LinkedList的元素的添加和删除,不是通过数组完成的,相对来说效率较高。
- LinkedList 的全面说明
- ArrayList 和 LinkedList 比较
- ArrayList 和 LinkedList 的比较
- 如何选择ArrayList和LinkedList:
- 如果我们改查的操作多,选择ArrayList
- 如果我们增删的操作多,选择LinkedList
- 一般来说,在程序中,80%-90%都是查询,因此大部分情况下会选择ArrayList
- 在一个项目中,根据业务灵活选择,也可能这样,一个模块使用的是ArrayList,另外一个模块是LinkedList,也就是说,要根据业务来进行选择
- 如何选择ArrayList和LinkedList:
- ArrayList 和 LinkedList 的比较
- Vector 的基本介绍
第五周
周一 2024/1/29
21. HashSet 与 LinkedHashSet
- Set接口和常用方法
- Set接口基本介绍
- 无序(添加和取出的顺序不一致),没有索引
- 不允许重复元素,所以最多包含一个
- JDK API中Set接口的实现类有:
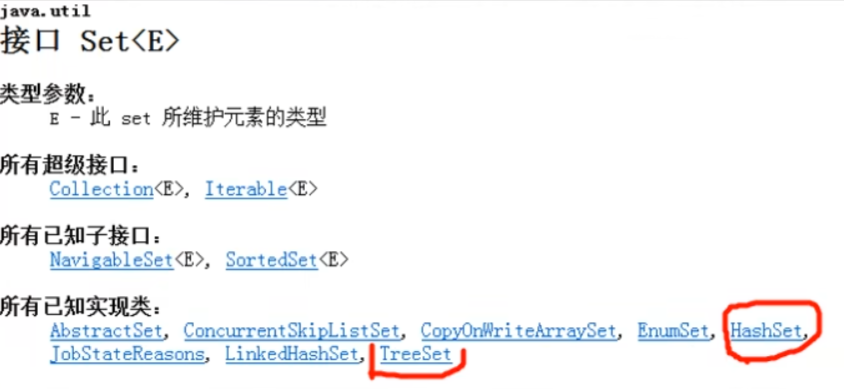
- Set 接口实现类-HashSet
- HashSet 的全面说明
- HashSet实现了Set接口
- HashSet:实际上是HashMap,看下源码.
public Hashset(){ map = new HashMap(); }- 可以存放null值,但是只能有一个null
- HashSet不保证元素是有序的,取决于hash后,再确定索引的结果.
- 不能有重复元素/对象
- HashSet底层机制说明
- 分析:HashSet底层是HashMap,HashMap底层是(数组+链表+红黑树)
- HashSet底层机制说明
- 分析:HashSet的添加元素底层是如何实现(hash()+equals())
- HashSet底层是HashMap
- 添加一个元素时,先得到hash值-会转成->索引值
- 找到存储数据表table,看这个索引位置是否已经存放有元素
- 如果没有,直接加入
- 如果有,调用equals比较,如果相同,就放弃添加,如果不相同,则添加到最后
- 在Java8中,如果一条链表的元素个数到达TREEIFY THRESHOLD(默认是8),并且tablel的大小>=MIN TREEIFY CAPACITY(默认64)就会进行树化(红黑树)
- 分析HashSet的扩容和转成红黑树机制
- HashSet底层是HashMap,第一次添加时,table数组扩容到16,临界值(threshold)是16*加载因子(loadFactor)是0.75=12
- 如果table数组使用到了临界值12,就会扩容到162=32,新的临界值就是320.75=24,依次类推
- 在Java8中,如果一条链表的元素个数到达TREEIFY THRESHOLD(默认是8),并且table的大小>=MIN TREEIFY CAPACITY(默认64),就会进行树化(红黑树),否则仍然采用数组扩容机制
- Set 接口实现类-LinkedHashSet
- LinkedHashSet 的全面说明
- LinkedHashSet是HashSet的子类
- LinkedHashSet底层是一个LinkedHashMap,底层维护了一个数组+双向链表
- LinkedHashSet根据元素的hashCode值来决定元素的存储位置,同时使用链表维护元素的次序(图),这使得元素看起来是以插入顺序保存的。
- LinkedHashSet不允许添重复元素